AMSI 是什么?
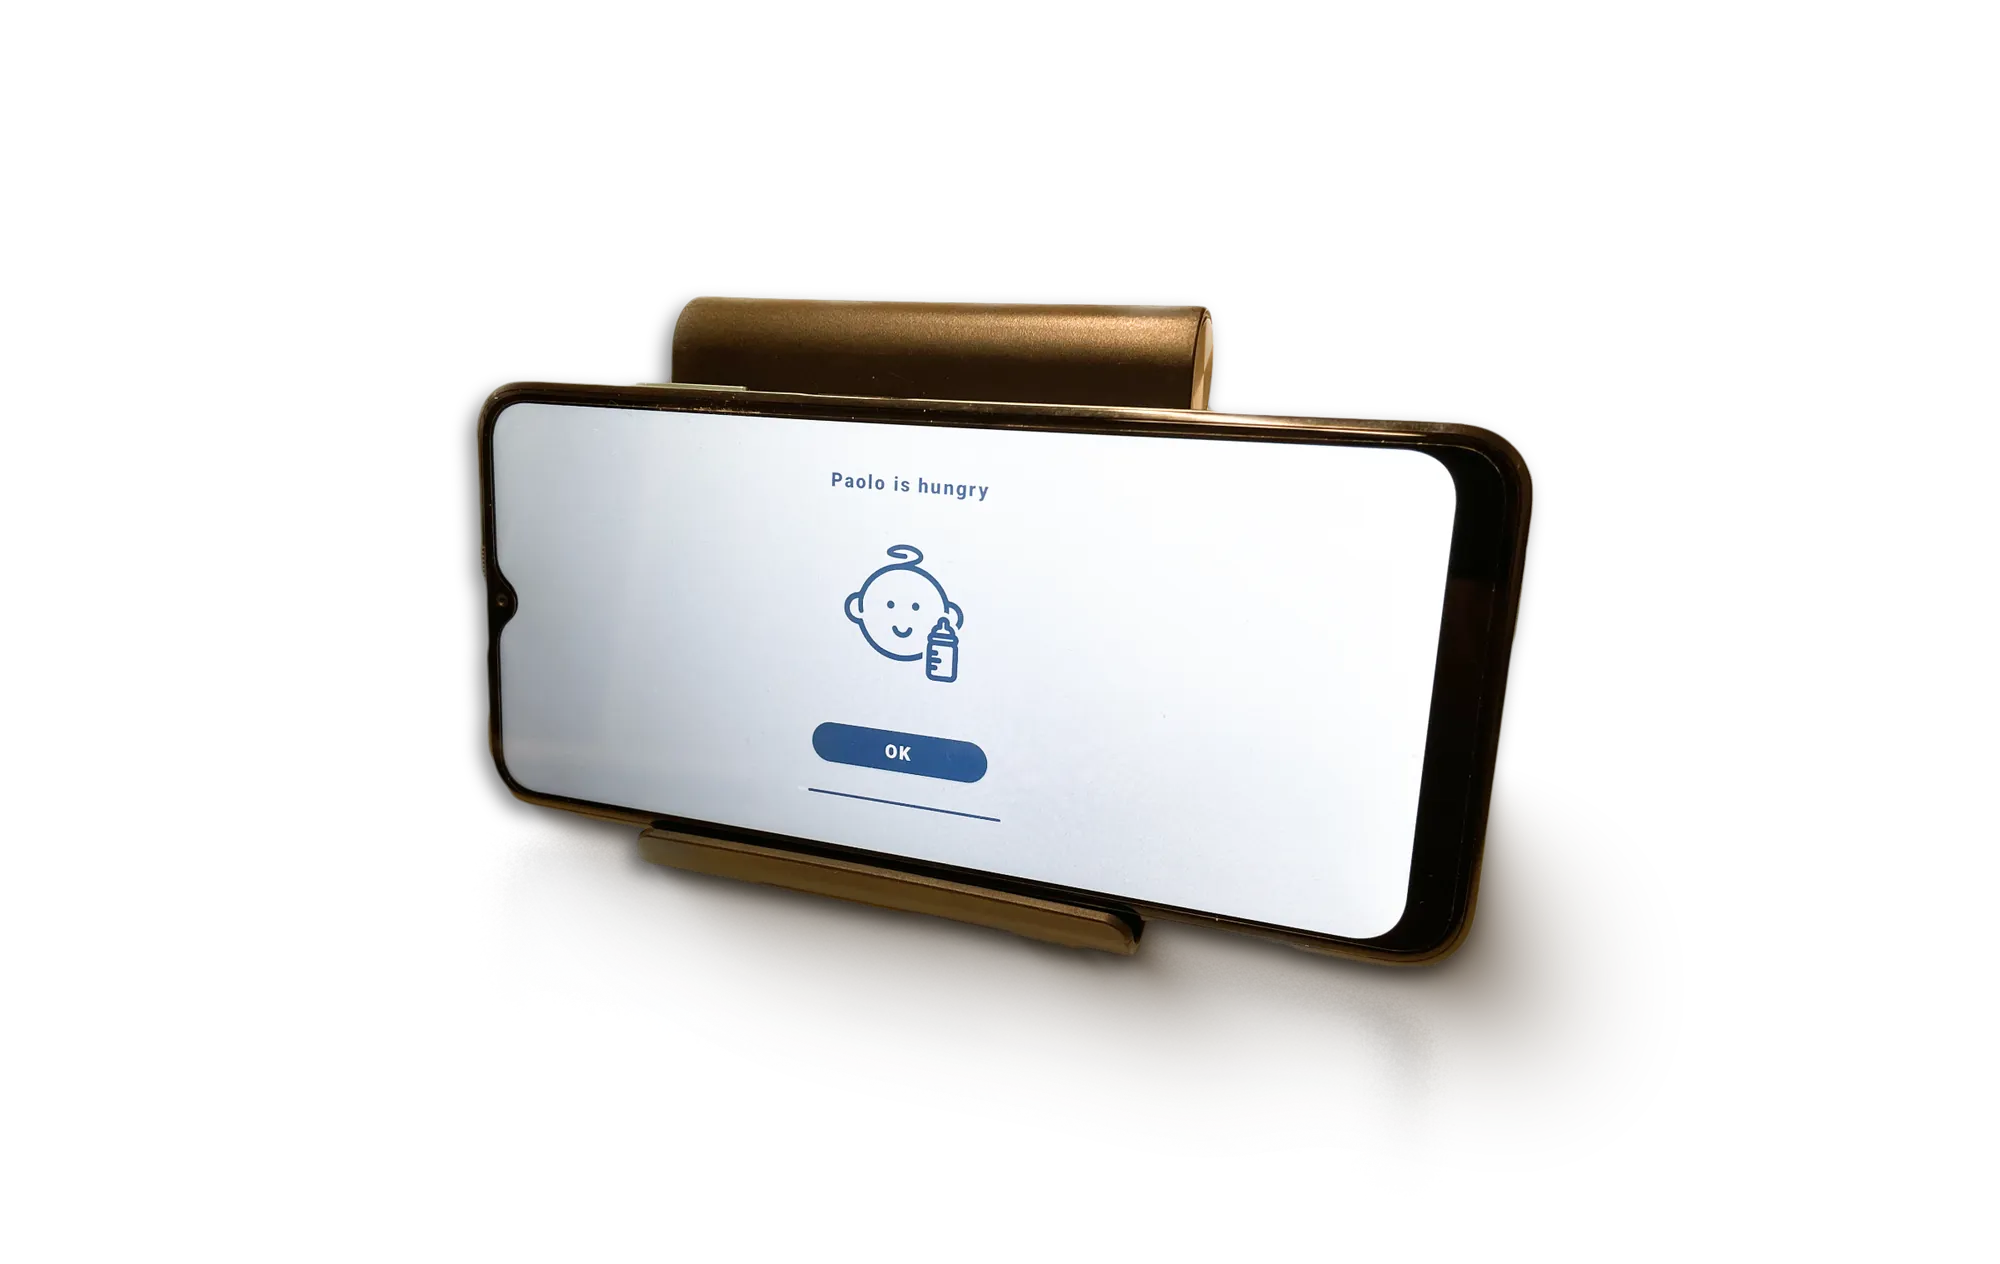
在 Zoundream,我们花了数月时间,寻找能够识别人类发出的声音、并将其转化为真实含义的方案,尤其是针对还不会说话的婴儿。机器学习文献中已有多种方法应对这一挑战,但它们都不适合处理连续输入的音频流。因此,我们开发了自己的深度学习方案。AMSI 是 Acoustic MultiStage Interpreter(声学多级解释器)的缩写,它通过一系列内部深度学习模型处理声音,提取婴儿哭声的含义。就像先认字,再组词,最后读懂完整的句子,这正是 AMSI 的工作方式。AMSI 可以适配多种不同的问题,未来还将能够识别宝宝更多的行为特征。
父母参与设计
技术开发以父母为导向,并持续在数百个家庭中进行测试,确保符合真实家庭的需要。
以扎实的研究为基础
科研专家参与开发过程并进行审核。我们与世界各地的医院和研究机构开展合作。
广泛适配各类硬件
AMSI 可在多种不同的硬件和平台上运行,原则上可用于各类配备麦克风的联网设备。
专注哭声分析的技术
经过多年的研究与积累,AMSI 专注于哭声分析这一具体领域。
超过 10 万小时的真实测试
AMSI 由真实的父母和他们的新生儿测试和使用。据 Zoundream 统计,截至 2021 年初,累计测试时长已超过 10 万小时,并在持续增长。
大规模哭声数据集
经过多年的大量测试,Zoundream 积累了大规模的哭声数据集,为这一特定应用领域提供支持。
将我们的技术适配到您的产品中
AMSI 现已是一个成熟的平台,我们将其提供给合作伙伴。最初,我们在一台仅用于测试的硬件设备上开发了 AMSI 原型。这一限制促使我们针对多种可能的架构(包括嵌入式硬件平台和移动系统)优化 AMSI 引擎。如今,我们已将 AMSI 迁移为基于远程服务的方案,借助云计算更强的算力,提供更准确的结果。